Latent Space
AI 工程師視角的技術深訪,是把論文和產品接起來的少數節目
 1:49:56
模型能認出分子出自哪位化學家,學到的是風格不是化學
給1815位化學家的分子做分類,模型靠作者風格就能猜中六成,卻學不到真實結合物理——這正是Leash堅持只用自產DEL數據訓練模型的原因。
 1:11:57
機器人不該只學動作,而要先學會預測整個世界
Dyna 的世界行動模型讓機器人先在想像裡生成未來視頻,再據此生成動作,創始人稱之為機器人版的思維鏈,也是它和 VLA 路線的根本分歧。
 31:56
AlphaFold沒解決蛋白質摺疊:複製的是沉積的靜態結構
AlphaFold復刻的只是PDB里人類已解出、沉積的那一個蛋白質構象,它從未學到真實的動態分布、無序區和摺疊路徑,這離科學上的「解決」還很遠。
 1:24:00
室溫超導體不會被AI一次性推算出來,得靠實驗室硬試
密度泛函理論再完美也裝不下10的23次方個原子,科學發現的本質就是訓練數據之外的東西——這是為什麼連下一代大模型也得靠物理實驗室反覆試錯。
 1:41:28
Claude Code 和 Codex 本質是同一套骨架:下一步紅利在換掉它
作者論證 Claude Code、Codex、Pi 這些主流編程 agent 拆開看設計選擇幾乎一致;真正帶來數量級提升的,是像 RLM 這樣把上下文卸載到磁盤、讓子智能體可組合的全新 harness 設計。
 39:12
OpenAI 一週內抄出競品 API:根本沒訓練新模型
決策 API 的誕生是看到對手產品爆火後的應激反應,OpenAI 一週內就做出競品,秘訣是直接在現有 Luna 模型上加結構化輸出和批量並行推理,根本沒訓練新模型。
 1:20:43
模型訓練不難,難的是送到開發者手上——頂級實驗室常年做不到
Anthropic花了一年多才讓Claude觸達開發者,OpenRouter卻能在新模型發布當天送去100萬開發者——分發,才是模型實驗室最大的短板。
 1:36:21
Runway 賭上 1000 張 A100:世界模型繞開數字孿生
Runway 在 Series B 階段就簽下 1000 張 A100 集群,賭視頻 scaling law 成立;如今世界模型只需一張環境照片就能 rollout 策略,繞開了為每個任務建數字孿生的老路。
 1:31:58
AI 能造出病毒了,防禦方還停在序列比對
生成致病序列的模型和判別序列是否致病的模型本質上是同一批模型,所以做設計的團隊最適合做防禦——但防禦側現在遠遠落後,基線還停在序列比對。
 2:01:26
AI 做科學卡在最後 0.001 分,不是卡在算力
ERA 能跑出成千上萬個候選 notebook,卻關不上最後 30 名的差距——因為內層是機器,外層還得靠人判斷「這篇論文你搞錯了」。
 2:20:53
RLHF 的代價是 mode dropping,不是對齊
RLHF 為了不出錯逼模型極度保守,把字符串概率分布整體毒化;TypeSafe 的 Jev 走另一條路,只優化 intelligence per dollar。
 1:26:14
AI 落地的瓶頸不是能力,是沒人敢簽字擔責
Waymo 四年前就比人開得好,卻至今進不了機場——約束 AI 有用性的從來不是能力,而是責任、風險和信任。AIUC 想用標準加保險補上這塊信心基礎設施。
 1:32:10
AI 能走出超立方體,但走不出已知概念
Socher 把智能拆成預測、行動、目標三個主成分,認為當前 AI 只能在已知概念的超立方體內工作,還無法定義全新概念或自造目標。
 1:23:31
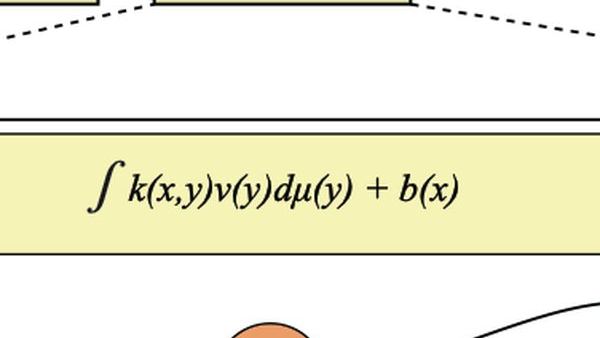
物理沒有基礎模型,神經算子用天氣預測補上這一課
Anima Anandkumar 用神經算子把天氣預測帶進 AI 時代:同樣精度快數萬倍、只用消費級 GPU,並展示物理世界如何用少量數據加幾何歸納偏置邁向基礎模型。
 1:09:38
模擬真人不是推理問題:前沿模型只有 20–30% 準確率
Joon Sung Park 的判斷:把人當作可訓練對象,需要的不是更強的推理模型,而是會犯和人一樣錯誤的模型——前沿模型在小眾人群行為預測上只有 20–30% 準確率,Simile 用兩小時深訪加 RCT 數據把它做到 85%。
 1:35:19
0.33Å誤差背後:藥物設計正從瀑布轉向敏捷閉環
Chai 為 50 個靶點設計抗體約一半命中,cryo-EM 驗證誤差 0.33Å;真正的護城河不是模型,而是數據、算力和讓藥企願付錢的驗證鏈路。
 1:41:29
量化更多層反而更準:誤差會互相抵消
選對層之後,量化更多反而更保真——誤差會互相抵消;同理 10 倍加速不是單點突破,而是量化、speculator、PD 分離各翻一倍疊出來的。
 1:09:28
Codex 內部被非程序員偷用,ChatGPT Work 順勢而生
OpenAI 把 Codex 的 harness 原樣搬給了知識工作者,只改 UX 取捨和 sandbox 默認值;背後的判斷是職能邊界會被 AI 抹平,所以拒絕按「你是誰」劃產品線。
 1:54:33
小模型死磕8周,能打破基礎模型寡頭壟斷嗎
Poolside用總參1180億、激活80億的小模型證明,持久性和驗證行為比單純堆參數量更能提升編程能力,這讓他們相信開源小模型能打破巨頭壟斷的未來。