Latent Space
AI 工程师视角的技术深访,是把论文和产品接起来的少数节目
 31:56
AlphaFold没解决蛋白质折叠:复制的是沉积的静态结构
AlphaFold复刻的只是PDB里人类已解出、沉积的那一个蛋白质构象,它从未学到真实的动态分布、无序区和折叠路径,这离科学上的「解决」还很远。
 1:24:00
室温超导体不会被AI一次性推算出来,得靠实验室硬试
密度泛函理论再完美也装不下10的23次方个原子,科学发现的本质就是训练数据之外的东西——这是为什么连下一代大模型也得靠物理实验室反复试错。
 1:41:28
Claude Code 和 Codex 本质是同一套骨架:下一步红利在换掉它
作者论证 Claude Code、Codex、Pi 这些主流编程 agent 拆开看设计选择几乎一致;真正带来数量级提升的,是像 RLM 这样把上下文卸载到磁盘、让子智能体可组合的全新 harness 设计。
 39:12
OpenAI 一周内抄出竞品 API:根本没训练新模型
决策 API 的诞生是看到对手产品爆火后的应激反应,OpenAI 一周内就做出竞品,秘诀是直接在现有 Luna 模型上加结构化输出和批量并行推理,根本没训练新模型。
 1:20:43
模型训练不难,难的是送到开发者手上——顶级实验室常年做不到
Anthropic花了一年多才让Claude触达开发者,OpenRouter却能在新模型发布当天送去100万开发者——分发,才是模型实验室最大的短板。
 1:36:21
Runway 赌上 1000 张 A100:世界模型绕开数字孪生
Runway 在 Series B 阶段就签下 1000 张 A100 集群,赌视频 scaling law 成立;如今世界模型只需一张环境照片就能 rollout 策略,绕开了为每个任务建数字孪生的老路。
 1:31:58
AI 能造出病毒了,防御方还停在序列比对
生成致病序列的模型和判别序列是否致病的模型本质上是同一批模型,所以做设计的团队最适合做防御——但防御侧现在远远落后,基线还停在序列比对。
 2:01:26
AI 做科学卡在最后 0.001 分,不是卡在算力
ERA 能跑出成千上万个候选 notebook,却关不上最后 30 名的差距——因为内层是机器,外层还得靠人判断「这篇论文你搞错了」。
 2:20:53
RLHF 的代价是 mode dropping,不是对齐
RLHF 为了不出错逼模型极度保守,把字符串概率分布整体毒化;TypeSafe 的 Jev 走另一条路,只优化 intelligence per dollar。
 1:26:14
AI 落地的瓶颈不是能力,是没人敢签字担责
Waymo 四年前就比人开得好,却至今进不了机场——约束 AI 有用性的从来不是能力,而是责任、风险和信任。AIUC 想用标准加保险补上这块信心基础设施。
 1:32:10
AI 能走出超立方体,但走不出已知概念
Socher 把智能拆成预测、行动、目标三个主成分,认为当前 AI 只能在已知概念的超立方体内工作,还无法定义全新概念或自造目标。
 1:23:31
物理没有基础模型,神经算子用天气预测补上这一课
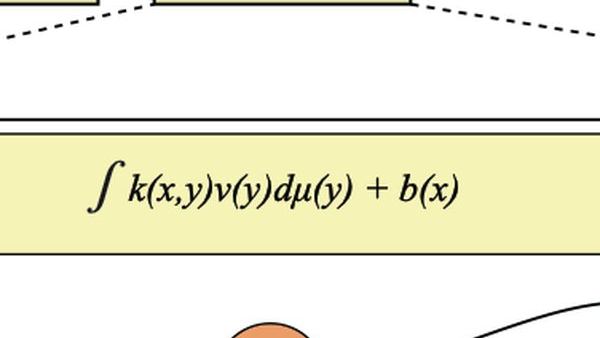
Anima Anandkumar 用神经算子把天气预测带进 AI 时代:同样精度快数万倍、只用消费级 GPU,并展示物理世界如何用少量数据加几何归纳偏置迈向基础模型。
 1:09:38
模拟真人不是推理问题:前沿模型只有 20–30% 准确率
Joon Sung Park 的判断:把人当作可训练对象,需要的不是更强的推理模型,而是会犯和人一样错误的模型——前沿模型在小众人群行为预测上只有 20–30% 准确率,Simile 用两小时深访加 RCT 数据把它做到 85%。
 1:35:19
0.33Å误差背后:药物设计正从瀑布转向敏捷闭环
Chai 为 50 个靶点设计抗体约一半命中,cryo-EM 验证误差 0.33Å;真正的护城河不是模型,而是数据、算力和让药企愿付钱的验证链路。
 1:41:29
量化更多层反而更准:误差会互相抵消
选对层之后,量化更多反而更保真——误差会互相抵消;同理 10 倍加速不是单点突破,而是量化、speculator、PD 分离各翻一倍叠出来的。
 1:09:28
Codex 内部被非程序员偷用,ChatGPT Work 顺势而生
OpenAI 把 Codex 的 harness 原样搬给了知识工作者,只改 UX 取舍和 sandbox 默认值;背后的判断是职能边界会被 AI 抹平,所以拒绝按「你是谁」划产品线。
 1:54:33
小模型死磕8周,能打破基础模型寡头垄断吗
Poolside用总参1180亿、激活80亿的小模型证明,持久性和验证行为比单纯堆参数量更能提升编程能力,这让他们相信开源小模型能打破巨头垄断的未来。